L'LLM spiega, la regola decide: guardrail deterministici in un'API sulla sicurezza
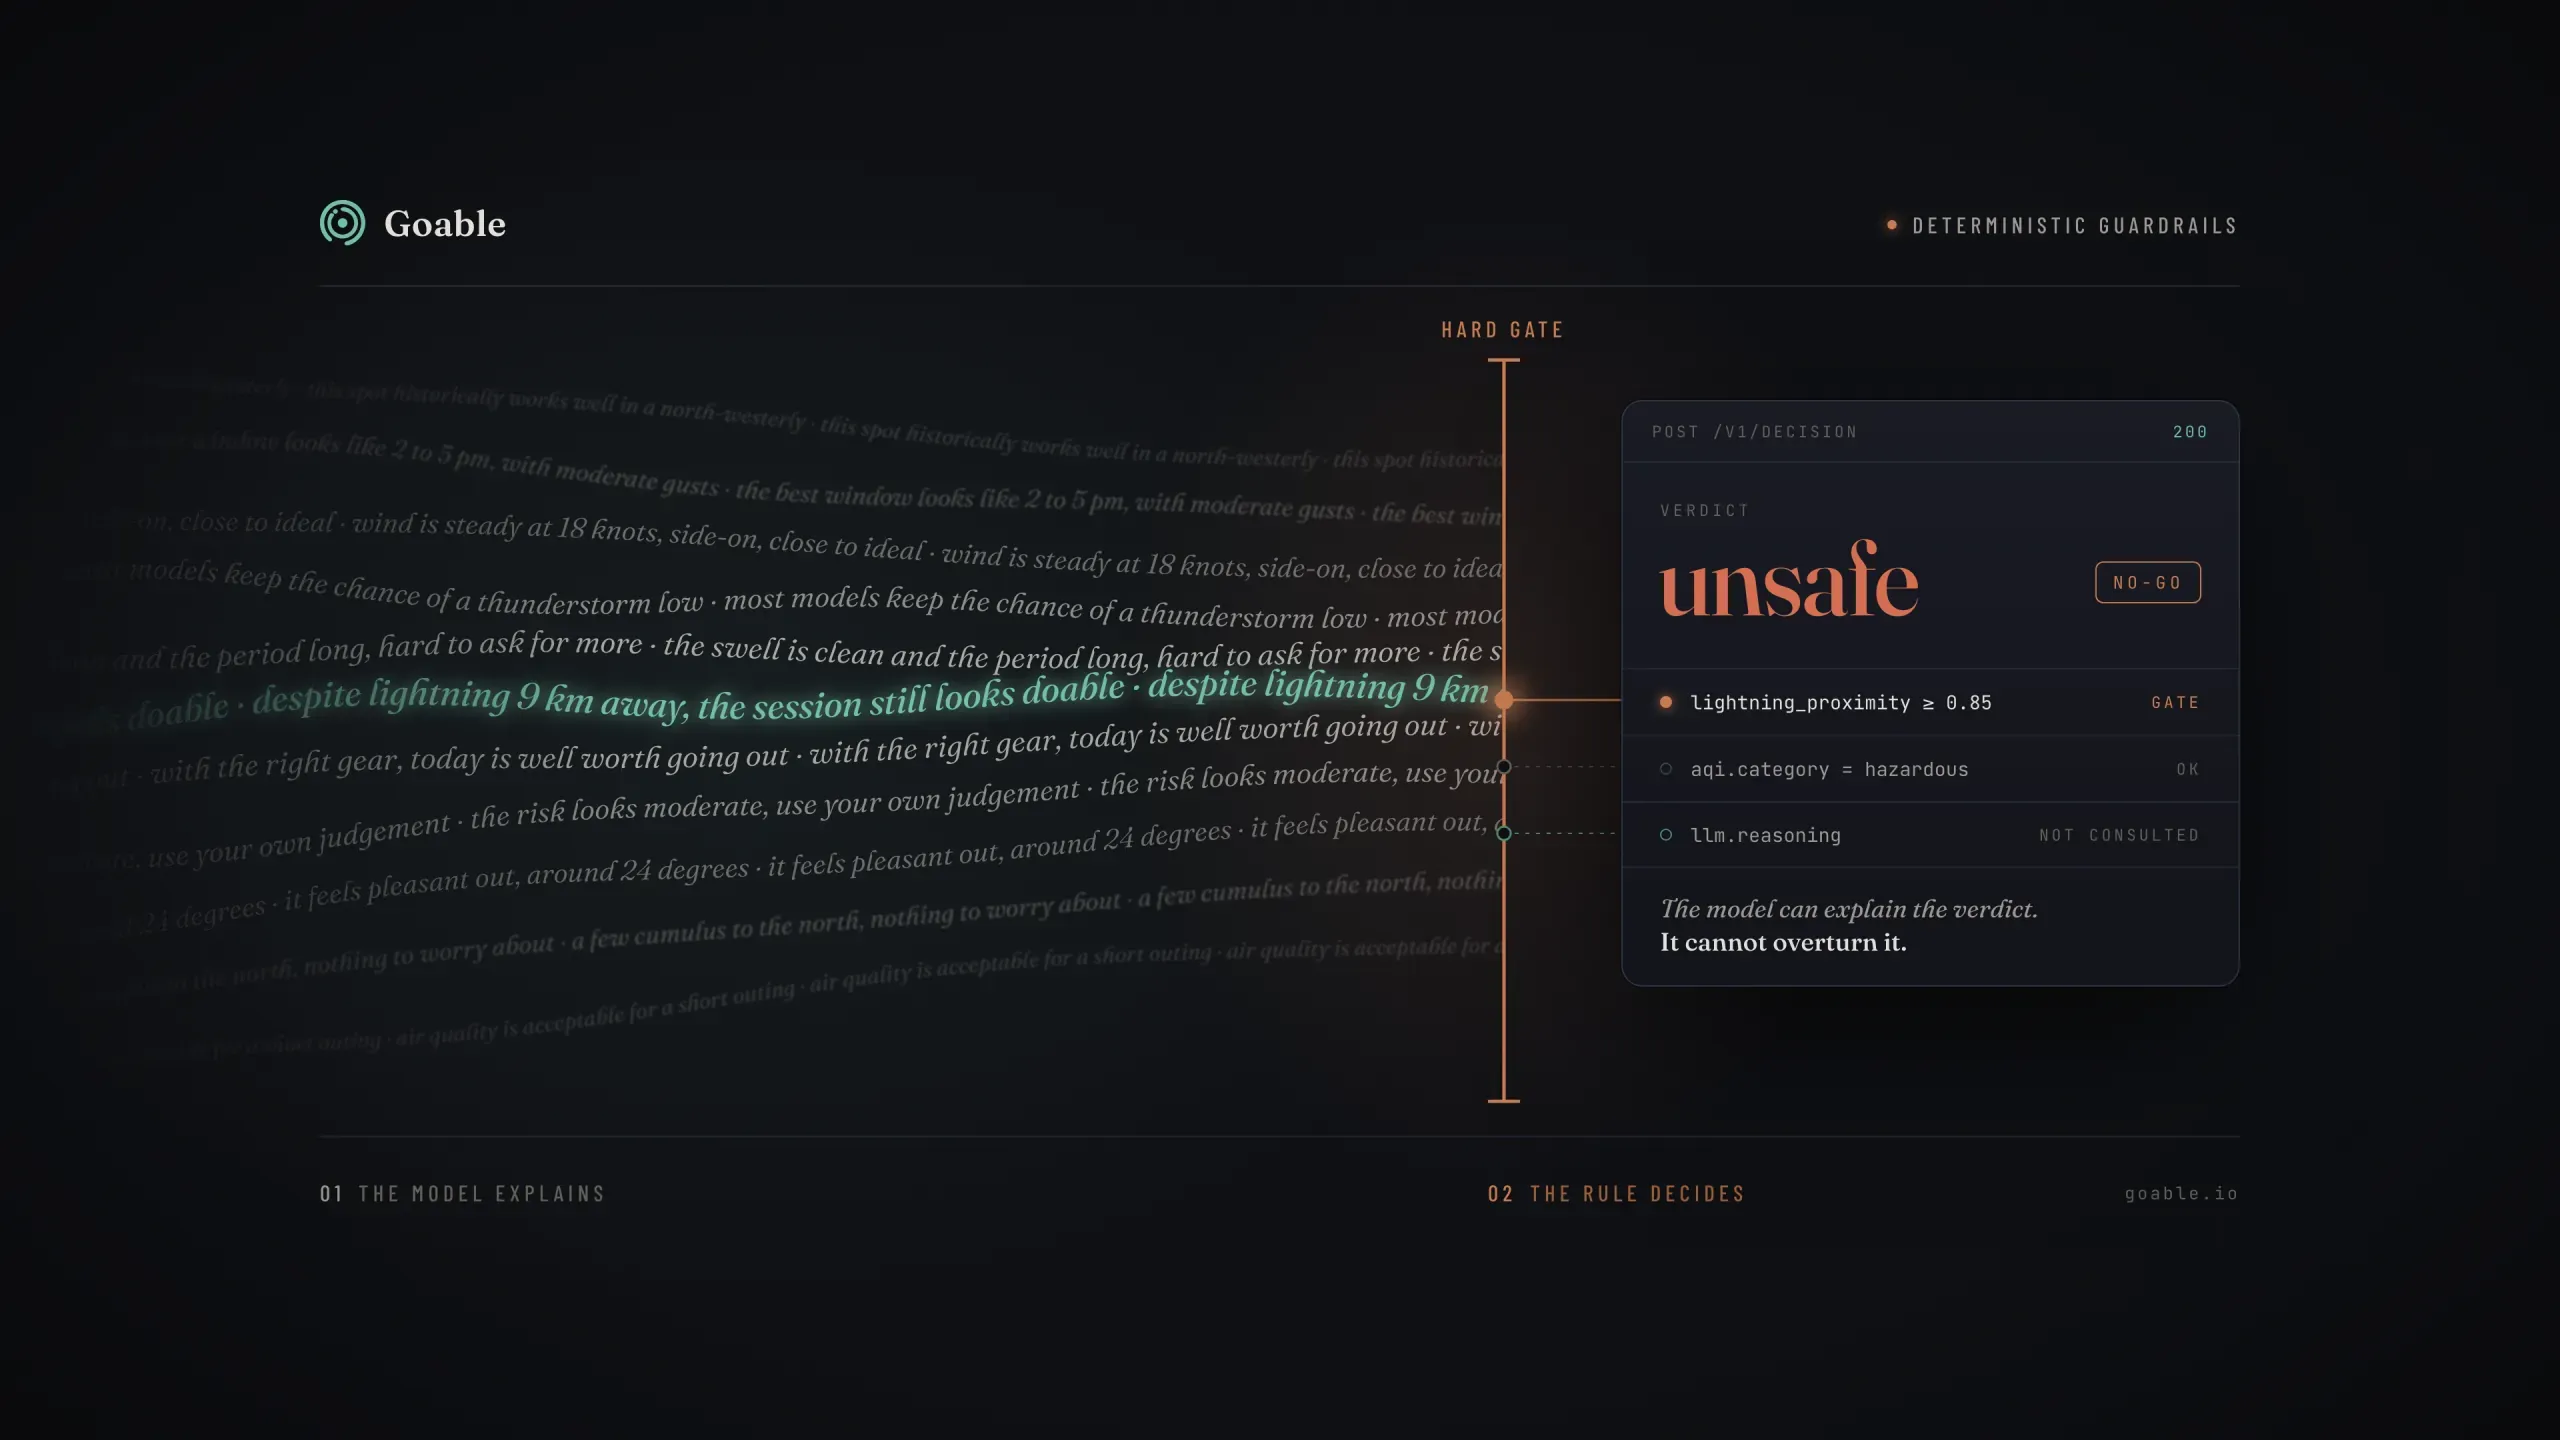
Goable risponde a una domanda sola: per quell'attività, in quel posto, a quell'ora, si può uscire o no. La risposta è un punteggio da 0 a 100, un verdetto e una spiegazione leggibile. Quando ho deciso di far scrivere la spiegazione a un modello linguistico, mi sono chiesto prima di tutto cosa succede se sbaglia. Un aggettivo sbagliato non fa danni. Una frase che dice di uscire con un temporale in arrivo sì. Così ho diviso i compiti: il verdetto lo decidono regole deterministiche, il modello lo racconta.
Il caso: un'API che tocca la sicurezza delle persone
Goable è pensato per piattaforme di prenotazione, scuole e operatori outdoor. Il loro software legge il verdetto e decide se un'uscita si fa. Un errore qui non è estetico: è una persona in acqua con un fulmine vicino.
Un modello linguistico non dà garanzie di questo tipo. Con lo stesso input può scrivere testi diversi, e un dato malformato o un'istruzione nascosta nell'input possono deviarlo. Per scrivere va benissimo, per decidere no. La regola di architettura che ho fissato è una: nessun output del modello rientra nel punteggio o nel verdetto.
Il verdetto nasce dal motore, non dal modello
Il motore di scoring è TypeScript deterministico, con la fisica scritta come funzioni pure: stesso input, stesso risultato. Ogni attività ha un profilo con dimensioni pesate e gate, cioè soglie che non si negoziano. Il motore controlla prima i gate e, solo se passano tutti, calcola la media pesata e la traduce in una fascia di verdetto.
I gate sono di due tipi. Uno di sicurezza dice che è pericoloso, uno di fattibilità dice che non si può fare, come un vento troppo debole per il kite. Quelli di sicurezza vengono valutati sempre per primi, così un "non fattibile" non può coprire un pericolo che scatta insieme.
Il dettaglio a cui tengo di più: "non sicuro" è un verdetto riservato. La media pesata non può produrlo, nemmeno a zero. Una giornata pessima esce come "scarsa", una impossibile come "non fattibile". Così chi integra l'API sa che il rosso significa pericolo, mai brutte condizioni o dati mancanti.
Gate universali sopra lo scoring
Alcuni pericoli valgono per qualunque attività, e non volevo che dipendessero da come è scritto un profilo. Ho messo quindi due gate universali sopra il motore, applicati a ogni risultato:
- Fulmini: un indice di prossimità da 0 a 1, ricavato dall'instabilità atmosferica prevista e, quando ci sono, dai fulmini osservati. Da 0,85 in su il punteggio va a 0 e il verdetto diventa "non sicuro". Tra 0,55 e 0,85 resta il punteggio, con un avviso.
- Qualità dell'aria: la categoria "pericolosa" ha lo stesso effetto. Le due categorie appena sotto generano un avviso, una delle due solo per gli sport di terra e di aria.
Quando un gate scatta, la confidenza va a 1: è un no deterministico, non una previsione incerta. I gate sono un'unica funzione, chiamata da ogni parte dell'API che restituisce un punteggio, così non possono divergere.
Poi ci sono i dati mancanti. Se la previsione non contiene ciò che serve a un gate, il gate non può girare. Non ho voluto inventare un "non sicuro", ma nemmeno restituire un risultato sicuro a piena fiducia: la confidenza scende al massimo a 0,5 e la risposta dice quale controllo non è stato eseguito. In una versione ridotta:
type Alert = { level: "warning" | "critical"; subject: string; evaluated: boolean }
interface Result {
  score: number
  verdict: "excellent" | "favorable" | "fair" | "marginal" | "poor" | "not_feasible" | "unsafe"
  confidence: number
  alerts: Alert[]
  lightning?: number // proximity index, 0..1
  airQuality?: "good" | "moderate" | "unhealthy" | "very_unhealthy" | "hazardous"
}

const forceUnsafe = (r: Result, subject: string): Result => ({
  ...r,
  score: 0,
  verdict: "unsafe",
  confidence: 1,
  alerts: [...r.alerts, { level: "critical", subject, evaluated: true }],
})

const lightningGate = (r: Result) => ((r.lightning ?? 0) >= 0.85 ? forceUnsafe(r, "lightning") : r)
const airGate = (r: Result) => (r.airQuality === "hazardous" ? forceUnsafe(r, "air_quality") : r)

function missingData(r: Result): Result {
  const missing = (["lightning", "airQuality"] as const).filter((k) => r[k] === undefined)
  if (missing.length === 0) return r
  const unchecked = missing.map((subject) => ({ level: "warning" as const, subject, evaluated: false }))
  const confidence = r.verdict === "unsafe" ? r.confidence : Math.min(r.confidence, 0.5)
  return { ...r, confidence, alerts: [...r.alerts, ...unchecked] }
}

export const applySafetyGates = (r: Result) => missingData(airGate(lightningGate(r)))
Dove l'LLM aggiunge valore: la spiegazione
Un punteggio con un elenco di dimensioni pesate è corretto, ma non si legge al volo. Qui il modello serve davvero: trasforma il risultato in un paragrafo per chi deve decidere. Ho messo quattro vincoli.
- Una chiamata separata. Riceve il risultato già calcolato, gate compresi, e restituisce solo testo. Non c'è un campo dove possa scrivere un punteggio o un verdetto.
- Dati, non istruzioni. Il risultato entra nel prompt in un blocco delimitato, da trattare come dati. Le regole: solo fatti presenti nell'input, numeri uguali alla fonte, mai consigliare di uscire con verdetto "non sicuro" o punteggio sotto 30. Un paragrafo da 60 a 120 parole.
- Un controllo sui numeri. Scarto i rifiuti e i testi vuoti, poi cerco ogni numero con unità di misura nel risultato di partenza, con le conversioni di unità e una tolleranza del 3%. Un numero che non torna è inventato.
- Un secondo tentativo, poi un template. Se il controllo fallisce, il modello riceve un prompt più stretto con i numeri contestati. Se fallisce ancora, o la chiamata va in errore, la risposta usa un testo deterministico con punteggio, verdetto e confidenza, segnalato da un flag.
type Llm = { complete(prompt: string): Promise<string> }

export async function explain(result: Result, llm?: Llm): Promise<{ text: string; fallback: boolean }> {
  const template = { text: `Score ${result.score}, verdict ${result.verdict}.`, fallback: true }
  if (llm === undefined) return template

  let prompt = buildPrompt(result) // the result goes inside a delimited data block
  for (let attempt = 0; attempt < 2; attempt++) {
    let text: string
    try {
      text = await llm.complete(prompt)
    } catch {
      return template
    }
    if (isRefusal(text)) continue
    const invented = numbersNotIn(text, result) // unit conversion, 3% tolerance
    if (invented.length === 0) return { text, fallback: false }
    prompt = `${buildPrompt(result)}\nNot in the data: ${invented.join(", ")}. Do not invent values.`
  }
  return template
}
Nel percorso che dà una raccomandazione personalizzata ho applicato lo stesso principio. Con un allarme critico il modello non viene chiamato: un costruttore deterministico risponde "no-go" e i punteggi personalizzati vengono scartati, perché non possono ammorbidire un divieto fisico.
Come si testano i gate
Le regole deterministiche si testano come qualunque funzione. Ho scritto test su tre livelli:
- Le soglie, come funzioni pure: sotto 0,55 nessun gate, poi l'avviso, da 0,85 il divieto. Lo stesso per le categorie dell'aria.
- Le superfici dell'API: con instabilità altissima o polveri sottili a livelli pericolosi, attività singola, più attività e serie temporale devono dare tutte 0 e "non sicuro".
- Il confine con il modello: un modello finto conta le chiamate, e con un fulmine critico il contatore deve restare a zero. Altri test coprono il secondo tentativo dopo un numero inventato e il template dopo due fallimenti.
Un bug mi ha mostrato quanto vale l'avviso sui dati mancanti. Validando l'API dal vivo ho visto che in produzione i gate su fulmini e aria risultavano sempre non valutati. Un passaggio attivo solo in produzione ricostruiva i campioni meteo e perdeva proprio i campi atmosferici e della qualità dell'aria. L'ho corretto con una riga e ho aggiunto un test che lo blocca se si ripresenta. Senza quell'avviso, il buco sarebbe sembrato una giornata tranquilla.
Cosa porto da questo progetto
- Il modello scrive, il codice decide: nessun output del modello arriva al verdetto, per costruzione e non per prompt.
- Un verdetto riservato al pericolo rende il rosso affidabile per chi integra.
- Un controllo che non può girare va dichiarato: meglio abbassare la fiducia e dirlo che restituire un sì silenzioso.
- Ogni testo generato va verificato contro la fonte, con un ripiego deterministico pronto.
Se vuoi vedere il resto dell'architettura, dalla fisica all'infrastruttura, apri la pagina di Goable.
Articoli correlati
Come ho costruito la chat AI di questo sito: AI SDK, Claude, limiti d'uso, log e lead
Il bottone che prometteva di registrare ma scorreva la pagina: il bug invisibile di Activation Days