Come ho costruito la chat AI di questo sito: AI SDK, Claude, limiti d'uso, log e lead
Una chat AI su un sito si mette in piedi in un pomeriggio. Il lavoro vero arriva dopo: decidere cosa il modello può dire, impedire che qualcuno la usi a mie spese, sapere cosa chiedono i visitatori e non perdere chi vuole parlarmi davvero. Qui racconto come ho costruito la chat di questo sito, cosa ho messo intorno al modello e cosa ho dovuto rifare.
Architettura: una route, l'AI SDK e Claude Haiku
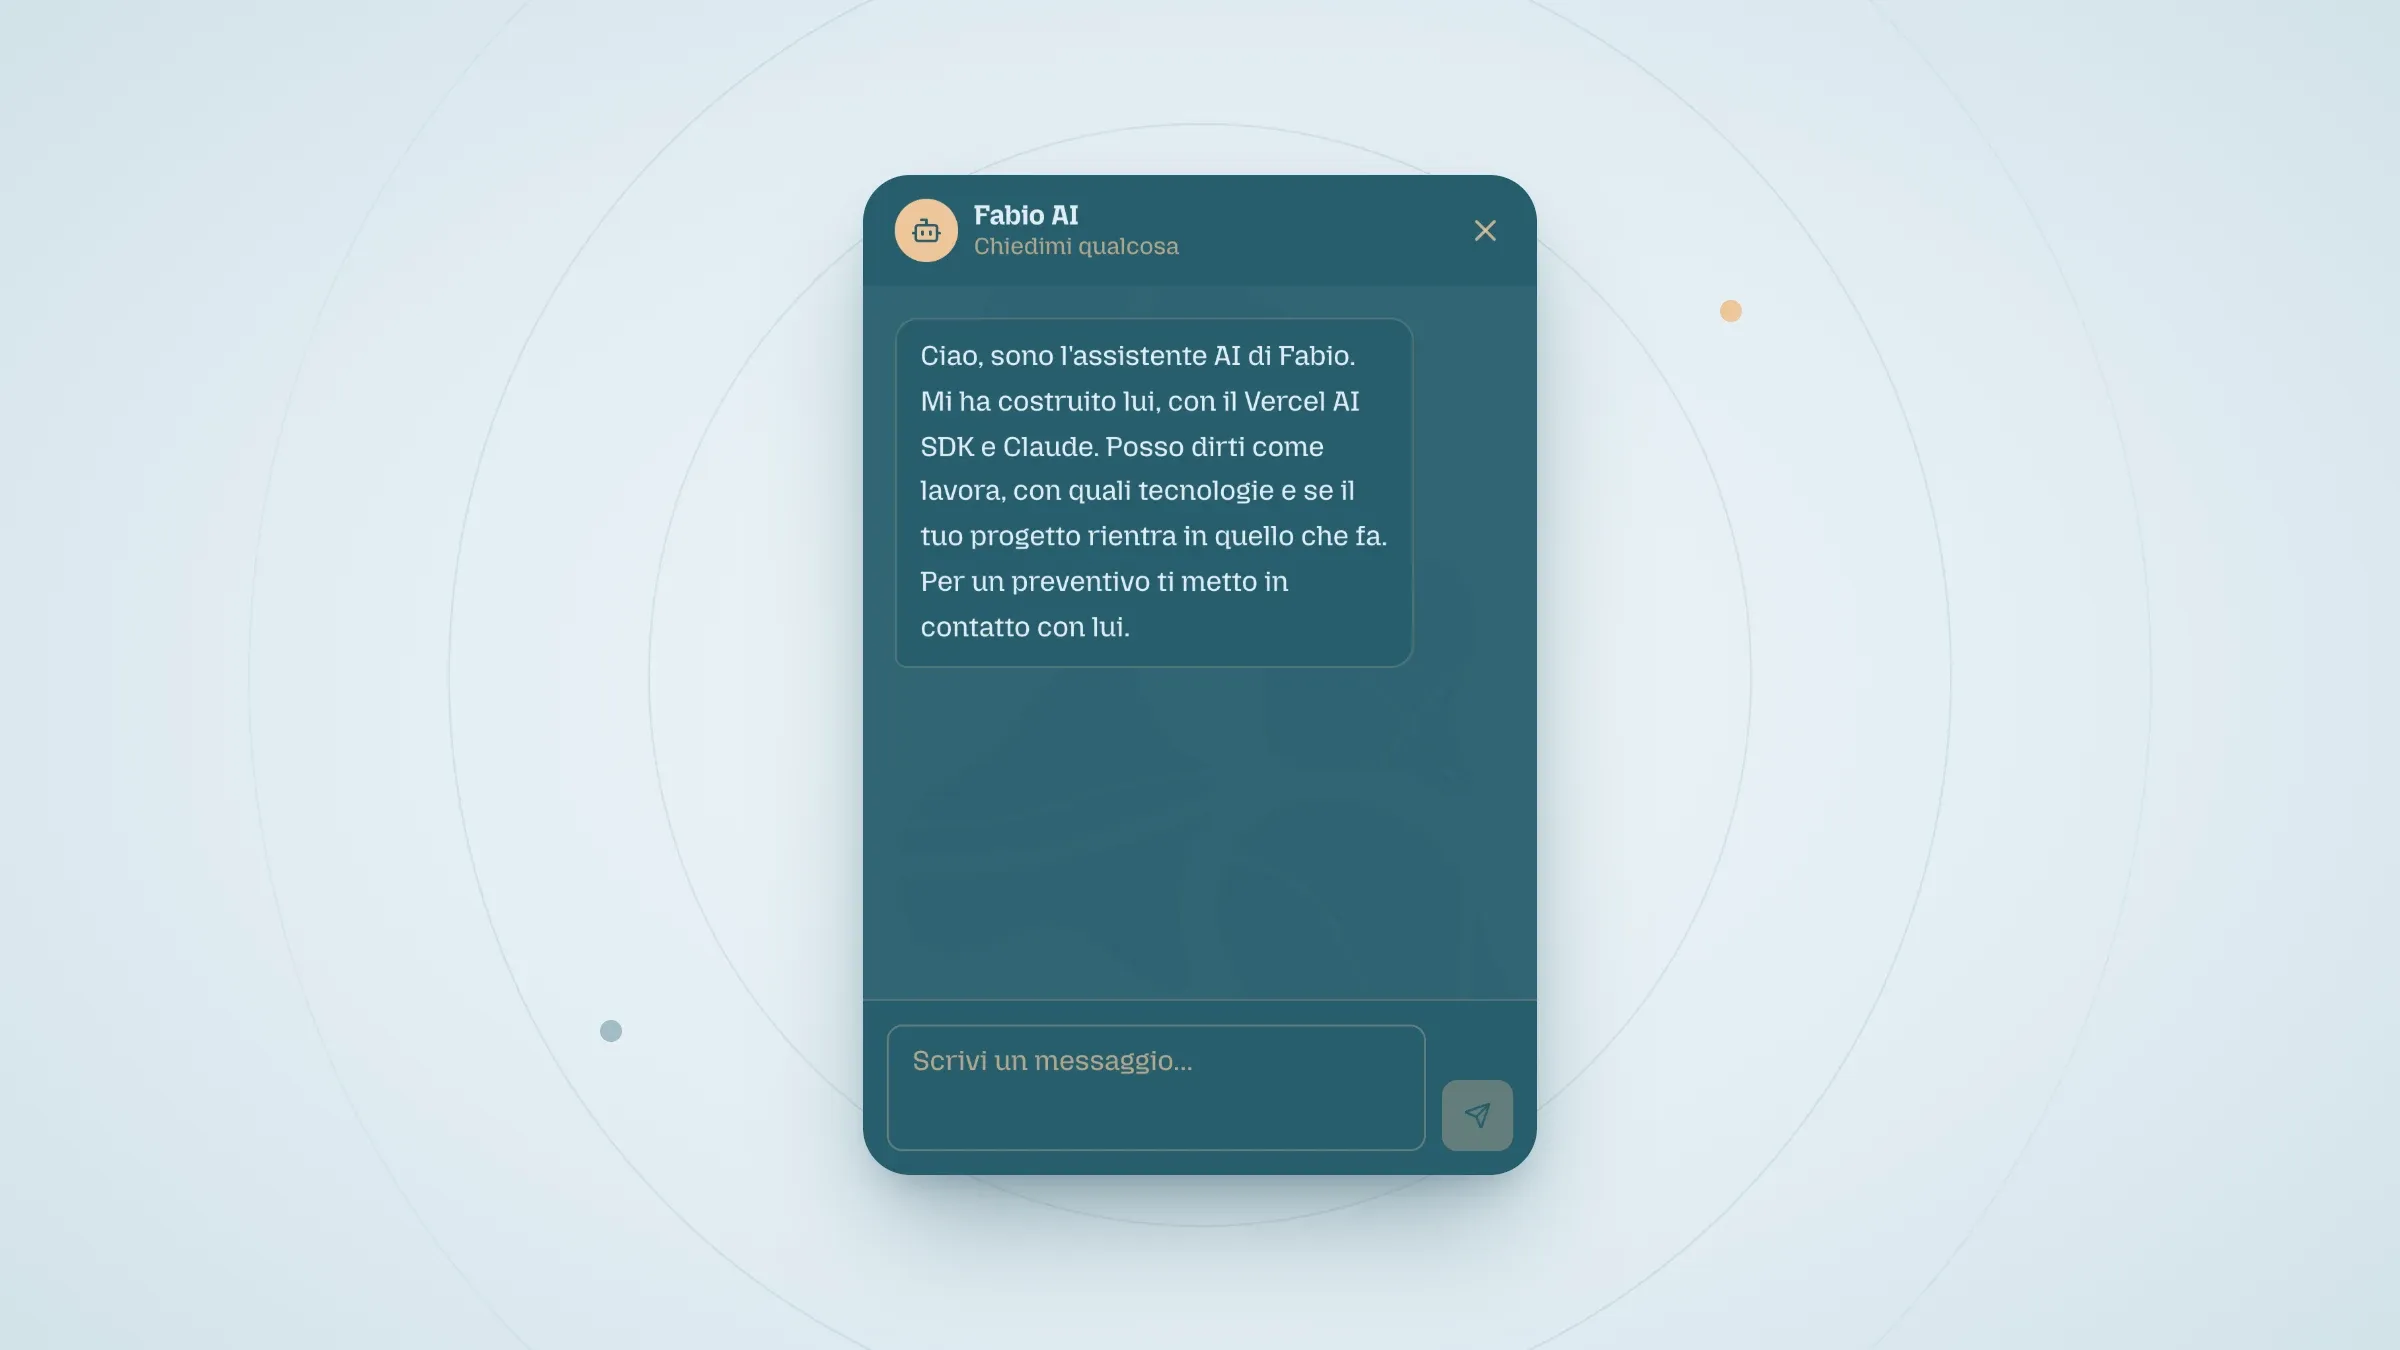
Ho diviso la chat in due parti. Nel browser, un widget React che usa useChat dell'AI SDK di Vercel. Sul server, una route di Next.js che riceve i messaggi, li passa a Claude Haiku 4.5 con streamText e restituisce la risposta in streaming.
Ho scelto Haiku perché le domande sono brevi, il contesto è circoscritto e ogni richiesta costa poco: servizi, modo di lavorare, progetti. Serviva un modello rapido che restasse nei binari.
Il pannello si porta dietro l'AI SDK, il renderer Markdown e il modulo contatti, quindi l'ho tolto dal bundle iniziale: lo scarico quando il visitatore passa sopra il pulsante o lo tocca, e lo monto al primo clic.
Cosa il modello può dire
Ho scritto il system prompt in modo che venga ricostruito a ogni richiesta. Una parte è fissa: profilo, modo di lavorare, servizi, cosa non faccio, contatti. L'altra arriva dal CMS: i progetti pubblicati più recenti, ognuno con il suo link, e le pagine dei miei prodotti. Quando pubblico un lavoro, la chat lo conosce senza che io tocchi il codice.
Le regole che ho scritto e che contano di più:
- risponde solo su di me, sul mio lavoro e su come contattarmi, nella lingua di chi scrive;
- se non sa una cosa lo dice e manda ai contatti, senza inventare;
- non dà mai prezzi, tariffe, range o stime, nemmeno indicative;
- non promette tempi di consegna, sconti o disponibilità;
- parla di me in terza persona: è il mio assistente, non me.
Valgono anche le regole di scrittura dei miei testi: frasi brevi, niente punti esclamativi, una lista di parole vietate.
Limiti d'uso: tre controlli prima del modello
Ogni messaggio alla chat è una chiamata a pagamento verso Anthropic. Una route aperta diventa un accesso gratuito a Claude per chiunque la trovi. Per questo ogni richiesta passa da controlli in ordine di costo crescente:
- BotID di Vercel scarta le richieste automatiche, prima di tutto il resto.
- Due limiti per IP, uno al minuto e uno all'ora. Il primo ferma le raffiche, il secondo chi resta sotto il primo ma continua per ore. Chi li supera riceve un errore 429 con i secondi da aspettare.
- Controlli sul contenuto: un numero massimo di messaggi per conversazione e una lunghezza massima per l'ultimo messaggio.
Ho messo anche un tetto alla lunghezza delle risposte.
Ho messo i contatori nella cache runtime di Vercel, condivisa tra le istanze di una regione. Con richieste contemporanee il conteggio può sbagliare di uno: per un portfolio l'ho ritenuto accettabile e l'ho scritto nel codice. Ecco l'idea in una versione semplificata:
import { anthropic } from "@ai-sdk/anthropic";
import { convertToModelMessages, streamText, type UIMessage } from "ai";
import { z } from "zod";

import { LIMITS } from "./chat-limits";

const WINDOWS = [
  { name: "minute", limit: LIMITS.perMinute, windowMs: 60_000 },
  { name: "hour", limit: LIMITS.perHour, windowMs: 3_600_000 },
];
const body = z.object({ messages: z.array(z.custom<UIMessage>()).min(1).max(LIMITS.messages) });

export async function POST(req: Request) {
  if (await isBot(req)) return json({ error: "bot" }, 403);

  const ip = clientIp(req);
  for (const w of WINDOWS) {
    const hit = await countHit(`${w.name}:${ip}`, w);
    if (hit.blocked) return json({ error: "rate_limited", retryAfter: hit.waitSeconds }, 429);
  }
  const parsed = body.safeParse(await req.json());
  if (parsed.error) return json({ error: "invalid" }, 400);
  const { messages } = parsed.data;

  const result = streamText({
    model: anthropic("claude-haiku-4-5"),
    system: await buildSystemPrompt(),
    messages: await convertToModelMessages(messages),
    onFinish: ({ text, usage }) => saveLog({ messages, text, usage }).catch(() => {}),
  });
  return result.toUIMessageStreamResponse();
}
Log delle conversazioni e raccolta dei contatti
Il salvataggio l'ho agganciato alla callback onFinish: quando la risposta finisce, la conversazione va nel CMS. Un documento per sessione: la prima domanda, la lingua, il numero di messaggi dell'utente, i messaggi tagliati a 500 caratteri ciascuno e il consumo di token. L'IP non lo salvo: salvo un hash troncato, calcolato con un valore segreto, che basta a riconoscere visite ripetute senza sapere chi sono. Se il salvataggio fallisce il visitatore non se ne accorge, perché il log non deve mai bloccare la risposta.
Ho chiuso i log a chi non è autenticato nel pannello del CMS, e ho aggiunto un job pianificato che ogni lunedì mattina mi manda un'email con il riepilogo della settimana e le ultime dieci conversazioni.
I log però non bastavano: il visitatore faceva le sue domande, riceveva risposte utili e chiudeva la scheda. Così ho aggiunto un pulsante che compare dopo la prima risposta vera dell'assistente, "Lascia i tuoi contatti a Fabio". Apre un modulo con nome, email e un messaggio facoltativo, validato con Zod sia nel browser sia sul server.
L'invio passa da una procedura tRPC con un suo limite per IP. Crea un lead nel CMS con una copia della conversazione, fino a 40 messaggi, e uno stato che aggiorno a mano: nuovo, contattato, chiuso. Poi mi arriva un'email con la trascrizione e il link al lead, così posso rispondere sapendo già cosa mi è stato chiesto. L'email è un tentativo, non un requisito: se l'invio fallisce il lead resta salvato e l'errore finisce su Sentry.
Cosa non ha funzionato
- Il primo limitatore era in memoria. Su serverless ogni istanza ha la sua memoria, quindi il limite non limitava niente. Ad aprile l'ho tolto, contando sui limiti dell'API di Anthropic. A maggio un audit ha segnalato la route come scoperta e ho rimesso i limiti, questa volta su una cache condivisa e con due finestre.
- Il primo log salvava un messaggio per riga. Una conversazione finiva sparsa su più documenti. Ad aprile sono passato a un documento per sessione, aggiornato a ogni risposta.
- Il primo messaggio arrivava senza sessione. L'identificativo entrava nella configurazione della chat quando il widget si montava, prima di essere generato, e senza sessione il log non veniva scritto. L'ho corretto passando l'identificativo insieme a ogni messaggio.
- Il prompt leggeva anche le bozze. La chat poteva citare un lavoro non ancora pubblicato. Ho filtrato la query sui soli contenuti pubblicati.
- All'inizio la chat parlava come se fosse me. Il primo prompt le chiedeva di rispondere come Fabio in persona. L'ho riscritto in terza persona, perché fosse chiaro chi sta parlando.
Cosa porto da questo progetto
- La chiamata al modello è la parte breve. Il lavoro sta intorno: regole, limiti, log e un passaggio verso una persona.
- I controlli vanno in ordine di costo: prima i bot, poi i contatori, poi il contenuto, e solo alla fine il modello.
- Su serverless un contatore in memoria non è un limite. Serve uno stato condiviso, anche semplice.
- Il contesto del prompt deve arrivare dal CMS, filtrato sui contenuti pubblicati, non essere ricopiato a mano.
Se vuoi vedere il resto del progetto, c'è il case study di questo sito.
Articoli correlati
L'LLM spiega, la regola decide: guardrail deterministici in un'API sulla sicurezza
Il bottone che prometteva di registrare ma scorreva la pagina: il bug invisibile di Activation Days